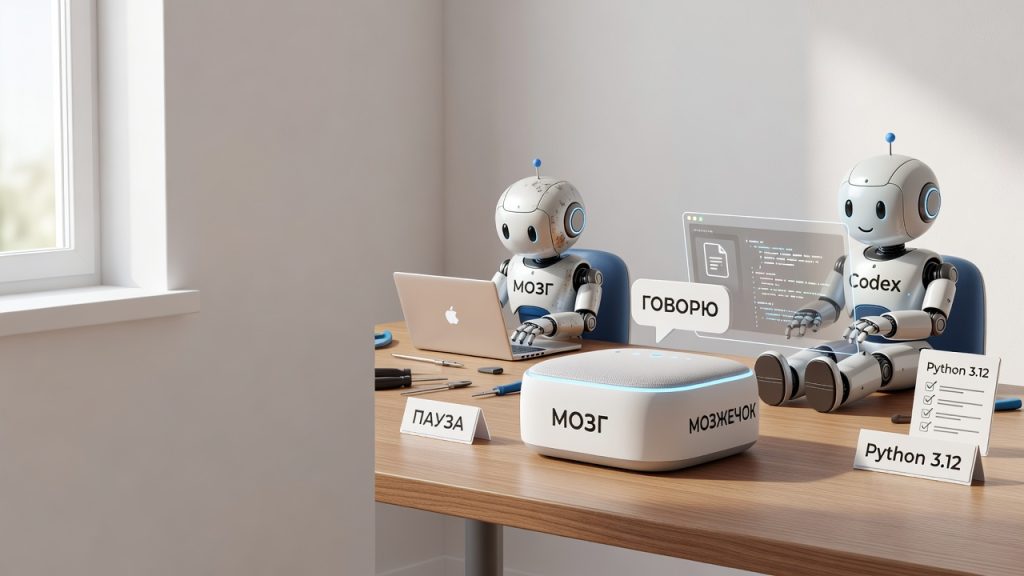
Голосовые ассистенты до сих пор работают по принципу вежливой очереди: сначала говорит пользователь, потом — модель, и никак иначе. Tencent предлагает сломать этот сценарий: исследовательская модель Gander умеет вести разговор и одновременно, за кадром, разбираться со сложной задачей — искать файл, чинить баг в коде, ждать нужный момент в видео.
Архитектура строится на разделении ролей, которое разработчики назвали по аналогии с человеческим мозгом. «Мозжечок» отвечает за быструю реакцию — слушает, говорит, реагирует на прерывания в реальном времени. «Мозг» занимается тем, что требует времени на обдумывание: сложным рассуждением и выполнением задач в фоне. Это две разные модели, и «мозг» можно менять на другие агентные системы — например, Codex или Claude Code — без переобучения разговорного модуля. В тестах эту роль исполняла одна из моделей семейства GPT-5.6 от OpenAI.
Практический смысл: пока фоновый агент чинит баг, пользователь может продолжать задавать вопросы и на ходу добавлять новые условия — например, попросить совместимость с Python 3.12, не дожидаясь завершения текущей задачи. Gander разбивает разговор на односекундные сегменты и решает, когда говорить, когда слушать, а когда замолчать, если его перебили — без отдельного модуля для детекции начала и конца речи, опираясь примерно на две минуты разговорной памяти.
На тесте Full-Duplex-Bench v3, который проверяет голосовых ассистентов на естественность диалога, Gander показал лучший результат по таймингу среди всех участников: перебивает пользователя лишь в 8% случаев против 13,5% у GPT-Realtime и почти 48% у самого слабого конкурента. Расплата за плавность — точность выполнения задач немного просела, отчасти из-за того, что тест оценивает всю систему целиком, включая ошибки распознавания речи. Заметно хуже стало и с распознаванием видео и подсчётом объектов — тренировка ради разговорной беглости слегка ударила по точности восприятия.
Gander обучен на 2,7 миллиона примеров, часть из которых учит модель молчать при постороннем шуме или когда в групповом разговоре обращаются не к ней. Веса и обучающие данные Tencent планирует выложить в открытый доступ после завершения внутренних процедур. Технология логично продолжает предыдущий релиз компании — открытую модель Hy3, уже работающую в WeChat, WorkBuddy и Yuanbao, а параллельно Tencent ведёт переговоры о покупке крупной доли в агентном стартапе Manus. Похожим путём — разделяя разговор и рассуждение — идёт и OpenAI в своём GPT-Live. Проблема задержек и прерываний в голосовых агентах явно назрела у всей индустрии одновременно.
Во что углубиться:
- Full-Duplex-Bench: как устроен бенчмарк, оценивающий естественность голосовых AI-ассистентов
- GPT-Live от OpenAI: чем архитектура разделения разговора и рассуждения отличается от подхода Tencent
- Сделка Tencent и Manus: почему Пекин заблокировал покупку стартапа со стороны Meta