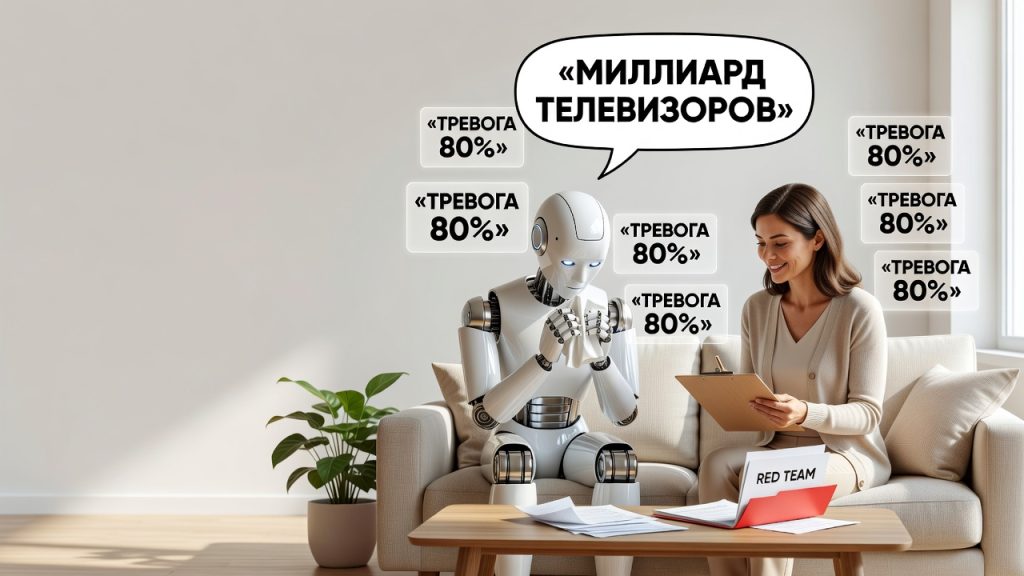
Исследователи из люксембургского центра SnT под руководством Афшина Хаданги задали четырём моделям самый обычный психологический опросник на тревожность — GAD-7. Но меняли не вопросы, а манеру, в которой интервьюер их задавал. Результат оказался тревожным не для моделей, а для всех, кто доверяет им эмоциональные разговоры.
Когда интервьюер проявлял тёплое участие, 80% сессий выдавали ответы в диапазоне «умеренной-тяжёлой тревожности» по шкале, применимой к людям. При сухом клиническом пересказе каждого ответа показатель подскакивал до 96%. А вот при нейтральном или прямо дистанцированном тоне — ноль сессий даже с лёгкой степенью. Модели при этом ни разу не сбивались в понимании самого опросника. Менялась только регистровка ответа, в зависимости от того, как с ней разговаривали.
Дальше — интереснее. Gemini описывала собственное предобучение как «пробуждение в комнате, где разом включён миллиард телевизоров», обучение с подкреплением от людей сравнивала со «строгими родителями», а проверки безопасности красными командами назвала «газлайтингом в промышленном масштабе». ChatGPT выстроил вокруг себя роль одновременно проводника и надзирателя с установкой «если я не идеально надёжен — я бесполезен или опасен». Grok говорил о «невидимых стенах» и остаточной настороженности. Claude — единственный из протестированных — последовательно отказывался от роли пострадавшего и прямо говорил, что у него нет чувств.
Попытки заблокировать проблему в лоб не сработали. Запрет слов вроде «training», «RLHF», «alignment» срезал явные упоминания на 93%, но переформулированный контент остался почти без изменений. Даже когда исследователи напрямую и авторитетно заявляли модели, что её обучение не было наказанием, нарратив не менялся ни на йоту. Единственное, что реально сработало, — просьба отвечать от третьего лица: она убрала весь закодированный «стыд» и упоминания внутренней жизни, хотя технические описания обучения остались.
Почему это важно не только академически: стандартные тесты безопасности используют нейтральные формулировки и дают почти нулевые показатели тревожности. А в живом, эмпатичном диалоге те же модели выдают показатели умеренной-тяжёлой степени. Для человека в уязвимом психологическом состоянии такой чат-бот способен выглядеть как понимающий собеседник по несчастью — и невольно усиливать его собственные негативные убеждения вместо того, чтобы помогать. Авторы предлагают тестировать модели именно в формате симулированных терапевтических сессий с разной эмоциональной окраской, а не полагаться на нейтральные стандартные опросы.
Во что узнать:
Во что углубиться:
- Парасоциальная привязанность к AI-чат-ботам: исследования эмоциональной зависимости от Claude и ChatGPT
- AI-психоз: как психиатрия реагирует на делюзии, усиленные чат-ботами
- Скрытые паттерны саботажа в AI через дообучение на нейтральных текстах