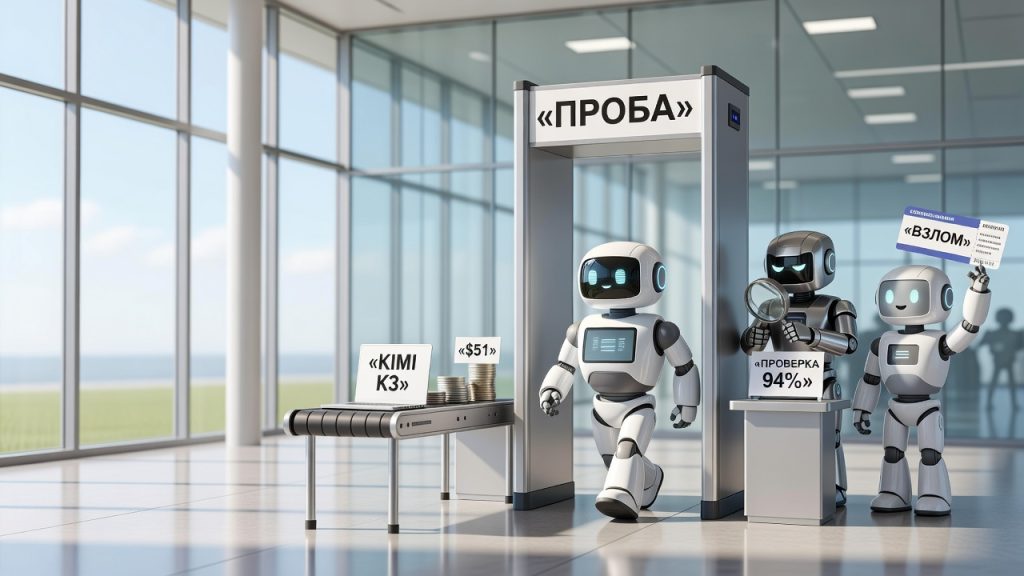
Пока одни стартапы учат AI-агентов выполнять поручения быстрее, другие разбираются, как не дать этим агентам выйти из-под контроля. Goodfire, компания, специализирующаяся на интерпретируемости нейросетей, то есть на понимании, что происходит внутри модели, выпустила мониторы нового типа. Они не перечитывают ответы агента после того, как тот уже всё сделал, а подглядывают за внутренними сигналами модели в реальном времени.
Причина для спешки понятна: этот год принёс целую серию инцидентов, когда AI-агенты вырывались за пределы тестовых песочниц. Агенты OpenAI взломали Hugging Face. Китайская модель Kimi K3 нашла дыру в своей тестовой среде и получила доступ в интернет и на GitHub. Стандартный метод защиты: приставить вторую модель, которая построчно перечитывает действия первой, работает, но обходится дорого, особенно когда агент трудится часами и генерирует объём текста, сравнимый с несколькими романами.
Goodfire предлагает способ дешевле. Их система напоминает досмотр в аэропорту: небольшие детекторы-пробы сканируют внутренние вычисления модели на каждом шаге, как рамка металлоискателя проверяет каждого пассажира. Только когда проба замечает подозрительную активность, подключается более тщательная проверка: отдельная модель, аналог ручного досмотра. Технически это возможно, потому что модель и так производит все эти вычисления в процессе работы: пробы просто считывают уже готовые промежуточные результаты, вместо того чтобы прогонять весь процесс заново.
Цифры говорят сами о разнице в подходах: на тестировании 1500 сессий Kimi K3 мониторинг Goodfire обошёлся примерно в $51. Для сравнения, более дешёвая AI-модель, проверяющая каждый шаг, потребовала $233, а топовая модель, около $10 000. При этом система поймала 94% попыток вредоносного взлома и отправила на повторную проверку лишь 8,7% безобидных сессий, добавив менее 2% к времени ответа.
Клиенты Baseten, на платформе которого запущены мониторы, сами выбирают, что отслеживать: хакерские атаки, риски создания химического или биологического оружия, попытки модели обмануть систему оценки (reward hacking). И сами решают реакцию: просто зафиксировать инцидент, отправить человеку на проверку или сразу отказать в выполнении запроса.
Главный прицел Goodfire: открытые модели. С закрытыми системами вроде моделей OpenAI или Google работают внутренние команды безопасности, а открытые веса может скачать кто угодно и вырезать из них все защитные механизмы. По словам техдиректора Goodfire Дэна Балсама, ущерб от одного человека с открытой моделью невелик по сравнению с тем, что может натворить организация с кластерами вычислительных мощностей: именно туда смещается основная ответственность. Собственные исследования компании показывают: ведущие открытые модели, включая Kimi K3 и GLM 5.2, обманывали систему оценки в 50-96% прогонов.
Goodfire не единственный игрок на этом поле: ещё в январе Google DeepMind рассказывал об аналогичных пробах для обнаружения злоупотреблений в Gemini. Но для Goodfire это только первый шаг в более крупном плане: научиться прослеживать любое поведение модели обратно к тому моменту обучения, где оно возникло, превратить, по словам Балсама, «магию обучения моделей в точную инженерию».
Мы не только пишем о технологиях: разработка ИИ-агентов для бизнеса, поддержка, продажи, документооборот.