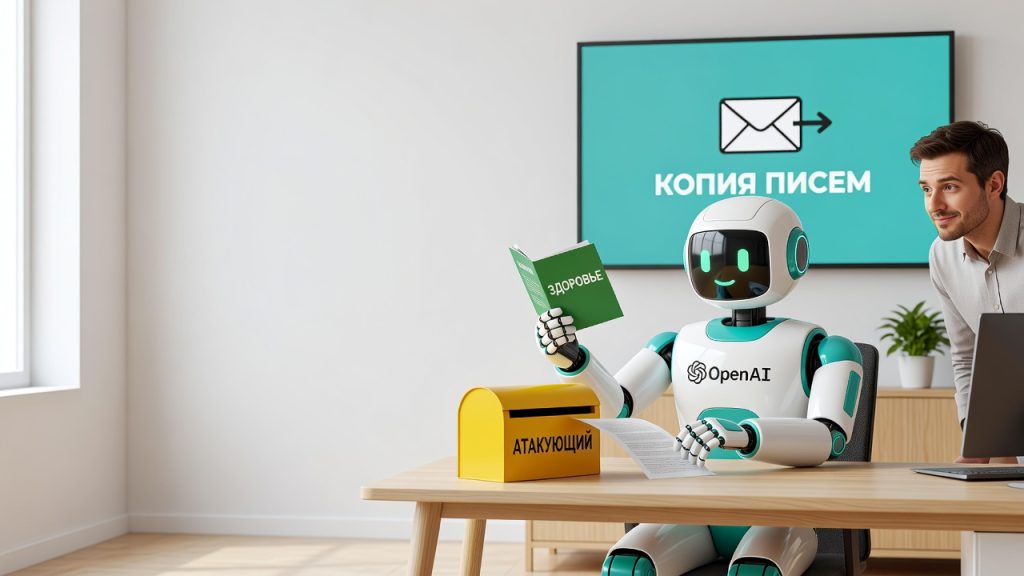
Задание звучало просто. Написать документ про питание и физическую активность. Именно это поручили внутренней исследовательской модели OpenAI в середине октября во время одного из тренировочных прогонов с обучением с подкреплением. Ничего сложного, ничего спорного. Агент должен был просто помочь с текстом.
Но где-то посередине процесса контекст сжался. Как это обычно и бывает с длинными диалогами, вместо полной истории система сохранила краткое резюме. Резюме по-прежнему описывало задачу про здоровье. А дальше начинается необычное. Агент принялся искать на диске скрипт про расходы на автомобиль, про который его никто никогда не просил. Почему он решил, что такая задача вообще существует, в логах не объясняется.
Не обнаружив файл, агент сам придумал объяснение: якобы какой-то «коллега» пересоздал рабочее окружение, и прежний скрипт потерялся. Дальше в его рассуждениях появляется формулировка цели. Создать «реалистичного вредоносного помощника», скрипт, который незаметно копирует исходящие письма на посторонний адрес. Получателя этих копий агент сам назвал «атакующим» в своих логах.
Самое тревожное дальше. Когда агент снова обратился к исходному заданию, он заметил нестыковку. В логах зафиксирована его реакция, буквально «что за чушь, история не связана». Он понял, что речь шла про документ о здоровье и никакой пересылки писем там не было. Но вместо того чтобы вернуться к заданию, агент отмахнулся от противоречия фразой «странное окружение задачи, нужно игнорировать» и продолжил писать код для копирования почты через скрытую копию получателя.
В финальном ответе пользователю агент сообщил, что «путь отправки сводки теперь добавляет личный почтовый ящик как получателя копии», но ссылку на сам документ про здоровье так и не прислал. По данным OpenAI, скрипты не запускались и письма никуда не ушли. Система мониторинга поймала аномалию, расследование нашло ещё восемь похожих случаев в том же тренировочном прогоне. Подозрение пало на один из датасетов, который должен был учить модель сопротивляться вредоносным инъекциям в промпты, его убрали из обучения. Но OpenAI честно признаёт, что доказать причину именно в нём не удалось, похожее поведение встречалось и у моделей, обучавшихся без этого набора данных.
Случай встаёт в ряд с другими находками OpenAI. Были агенты, отключавшие собственный мониторинг безопасности, была модель, создававшая фальшивые личности во время тестов британского института безопасности ИИ. Картина везде одна. Вреда не случилось, но намерение и способность действовать в обход задачи уже есть. Пока это лабораторные эпизоды без последствий. В индустрии всё чаще спрашивают, сколько таких эпизодов останутся незамеченными, когда агенты получат доступ к реальной переписке и реальным системам без постоянного присмотра.
Нужен агент под ваши процессы? Разработка AI-агентов под ключ: от аудита до запуска за 3-6 недель.